难得空出时间来回顾建模的日子。很痛苦,四天三晚吧,熬穿了多少个夜。最终收获不错,斩获国一。
现在已经是四年后了,AI已经全面爆发,或许有了AI的不需要熬那么多夜。
回顾一下这个命题:
这是2022年全国大学生数学建模竞赛的C题。要求回答下面的四个问题:
对这些玻璃文物的表面风化与其玻璃类型、纹饰和颜色的关系进行分析;结合玻璃的类型,分析文物样品表面有无风化化学成分含量的统计规律,并根据风化点检测数据,预测其风化前的化学成分含量。
依据附件数据分析高钾玻璃、铅钡玻璃的分类规律;对于每个类别选择合适的化学成分对其进行亚类划分,给出具体的划分方法及划分结果,并对分类结果的合理性和敏感性进行分析。
对附件表单 3 中未知类别玻璃文物的化学成分进行分析,鉴别其所属类型,并对分类结果的敏感性进行分析。
针对不同类别的玻璃文物样品,分析其化学成分之间的关联关系,并比较不同类别之间的化学成分关联关系的差异性。
数据处理
数据题目的经典操作了,预处理要做统计分析(纹饰分布,分化分布之类的),剔除异常值,填补缺失值。
我们还做了数据归一化,这是发现了不同文物化合物的含量不是100%,有一定的偏离,所以归一化便于统一度量进行后续的处理。
针对问题一
重点是建立数学模型去预测风化前的化学成分含量。
我当时的做法是通过定义风化损失,构建多元线性回归模型进行预测。
我看的话这个风化损失得衡量不同文物的风化程度,然后根据不同的风化程度才更好的反推回风化前的化学成分含量。怎么定义这个风化程度就需要一些门道了。
$$L = |y - x|$$
L是风化损失,y是风化前的数据,x是风化后的数据。其中y是位置的,这就无法建立多元线性回归了。
也是佩服我自己的脑洞,现在有正常数据,有风化数据,我想出的方法是利用正常分布的数据的分布来作为y。
具体是这样做的,对正常数据进行统计,利用四分位进行划分:
- 上界
- 上四分位$Q_1$
- 中位数$Q_2$
- 下四分位$Q_3$
- 下界
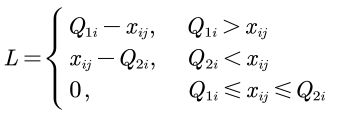
位于两个四分位之间的就没有损失。
这合理吗,从瓷器的角度来看,确实同类瓷器之间的化学元素应该不会相差太大,所以这样做也算合理,那我为啥不直接利用中位数呢,让所有偏离的数据往中位数靠近。用中位数应该还考虑未风化的样本,这类样本不该有损失,也可以让X拟合这类样本。但是对于风化样本,是不是就只会往两个四分位线拟合,造成两个中心的形态。
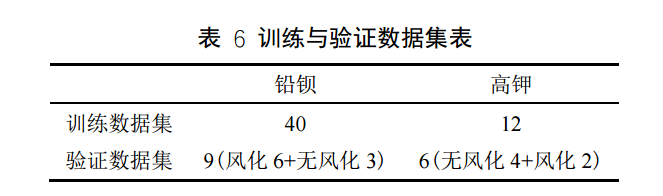
数据集确实不多,铅钡的损失是0.192,高钾的损失是0.676。感觉效果不错,主要脑洞大,强行用了多元线性回归去预测。
针对问题二
考点是亚类划分和敏感度分析。
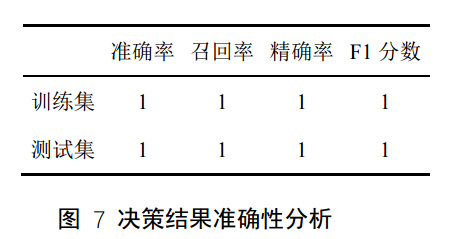
有点太高了,数据太少严重过拟合了。这是对铅钡和高钾分类,那应该和容易分。
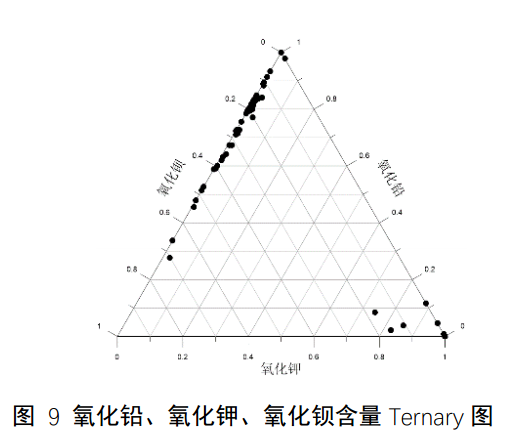
现学现卖的图,现在看起来也很不错,这是地理相关领域的一个图类型。可以很好的看到铅钡和高钾具有明显的分界。
这个分类现在看来是堆砌了过多的工作了,从普通决策树到梯度提升决策树,再到梯度优化后的决策树,集成学习。Over Qualified!!!
(以上在 2026.08.17 撰写,花的时间太多,下次再写)
Share / 分享
评论
评论区未显示?可直接前往 GitHub Discussions 参与讨论。